





 AI/ML
 Rozwój oprogramowania


Wie wir ein KI-System zur Zungenanalyse auf Basis der TCM entwickelt haben
Kunde
Der Kunde entwickelt digitale Diagnoselösungen im Bereich der Traditionellen Chinesischen Medizin (TCM), in der die Zungenanalyse ein zentrales Element zur Beurteilung des Gesundheitszustands eines Patienten ist. In der Praxis bedeutet dies die Arbeit mit Bildern sowie die Interpretation subtiler visueller Merkmale wie Farbe, Belag, Risse oder Zahnabdrücke. Diese Merkmale werden anschließend diagnostischen Syndromen zugeordnet.
Bisher wurde der gesamte Prozess manuell von einem Experten durchgeführt. Dies begrenzte die Skalierbarkeit, da die Anzahl der Analysen direkt von der Verfügbarkeit von Spezialisten abhing. Zudem verlängerte sich die Bearbeitungszeit und es entstand eine natürliche Variabilität in der Interpretation. Der Kunde benötigte eine Lösung, die den Durchsatz erhöht, ohne die Qualität zu beeinträchtigen, und langfristig eine teilweise oder vollständige Automatisierung ermöglicht.
Herausforderung
Die größte Herausforderung war nicht der Einsatz von Deep Learning selbst, sondern der Aufbau einer sinnvollen KI-Pipeline unter Bedingungen, die weit von einer „Laborumgebung“ entfernt sind.
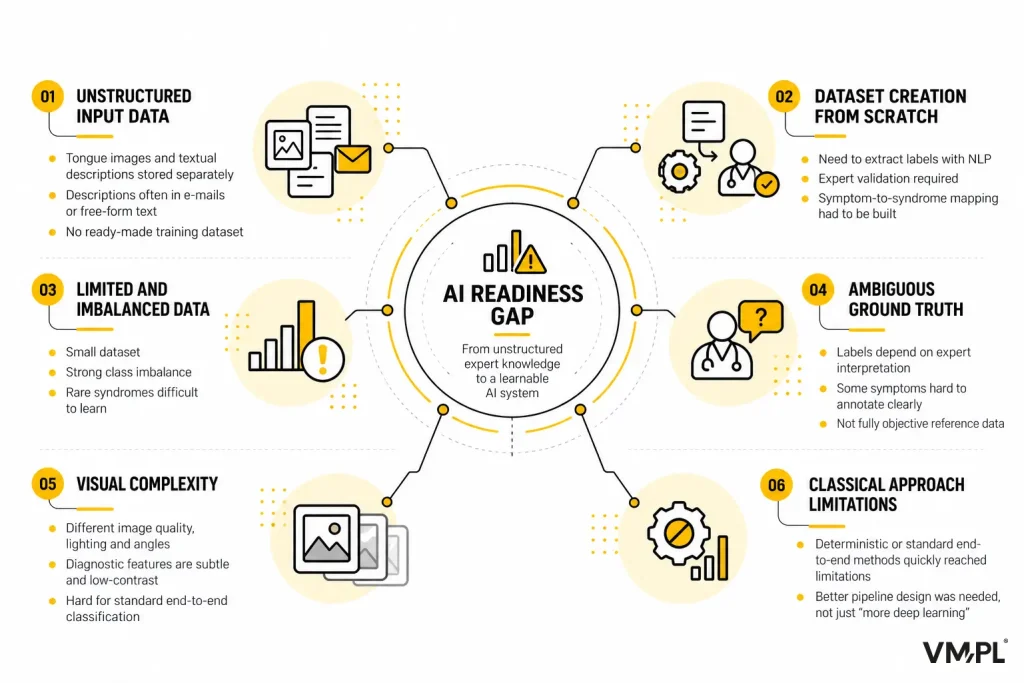
Die Eingangsdaten waren unstrukturiert. Bilder der Zunge und ihre Beschreibungen existierten getrennt voneinander, oft verteilt über E-Mail-Verläufe, und die Beschreibungen lagen in freier Textform vor. Das bedeutete, dass kein fertiger Trainingsdatensatz vorhanden war und dieser von Grund auf aufgebaut werden musste, einschließlich der Extraktion von Labels mittels NLP sowie deren Validierung durch Experten.
Zusätzlich war die Datenmenge begrenzt und stark unausgewogen. Einige Syndrome traten selten auf, was das Training von Modellen im klassischen Klassifikationsansatz erschwerte. Das Problem wurde dadurch verstärkt, dass die Ground Truth nicht vollständig objektiv war. Die Interpretation hing vom jeweiligen Experten ab, und einige Symptome waren schwer eindeutig zu kennzeichnen.
Auch aus visueller Sicht war die Herausforderung groß. Die Bilder unterschieden sich in Qualität, Beleuchtung und Aufnahmewinkel, während die diagnostischen Merkmale oft subtil und kontrastarm waren. In der Praxis bedeutete dies, dass ein klassischer End-to-End-Klassifikationsansatz schnell an seine Grenzen stieß.
Lösung
Anstatt eines einzelnen Klassifikationsmodells haben wir eine Pipeline entwickelt, die der Logik eines Experten entspricht.
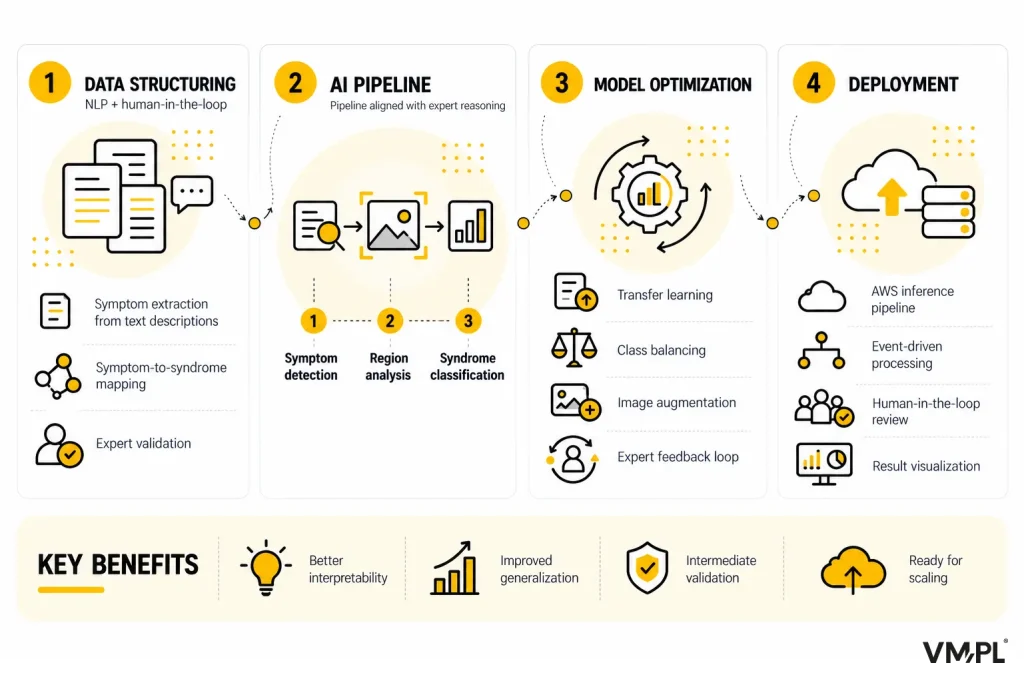
1. Datenstrukturierung (NLP + Human-in-the-loop)
- Extraktion von Symptomen aus textuellen Beschreibungen,
- Aufbau eines Merkmalskatalogs und Mapping Symptom zu Syndrom,
- iterative Validierung durch Experten.
2. Modellarchitektur (CNN + Transfer Learning)
Wir haben zwei Ansätze verglichen:
A. End-to-End-Klassifikation von Syndromen
Schnell, aber mit geringer Interpretierbarkeit und schwächerer Performance.
B. Dreistufige Pipeline (finaler Ansatz):
- Symptomerkennung (Multi-Label),
- Analyse von Zungenregionen (Lokalisierung von Merkmalen),
- Klassifikation von Syndromen.
Warum dieser Ansatz besser funktioniert hat:
- Aufteilung des Problems in einfachere Teilaufgaben,
- bessere Generalisierung bei kleinen Datensätzen,
- Möglichkeit zur Validierung von Zwischenergebnissen.
3. Optimierung
- Transfer Learning mit vortrainierten CNNs,
- Ausgleich unausgewogener Klassen,
- Bilddaten-Augmentierung,
- iterative Validierung mit Experten im Feedback-Loop.
4. Implementierung (Production-ready PoC)
- skalierbare Inferenz-Pipeline auf AWS,
- eventbasierte Verarbeitung nach dem Upload von Bildern,
- Visualisierung der Ergebnisse mit hervorgehobenen Symptomen,
- Human-in-the-loop-Modus mit Expertenvalidierung.
Ergebnisse
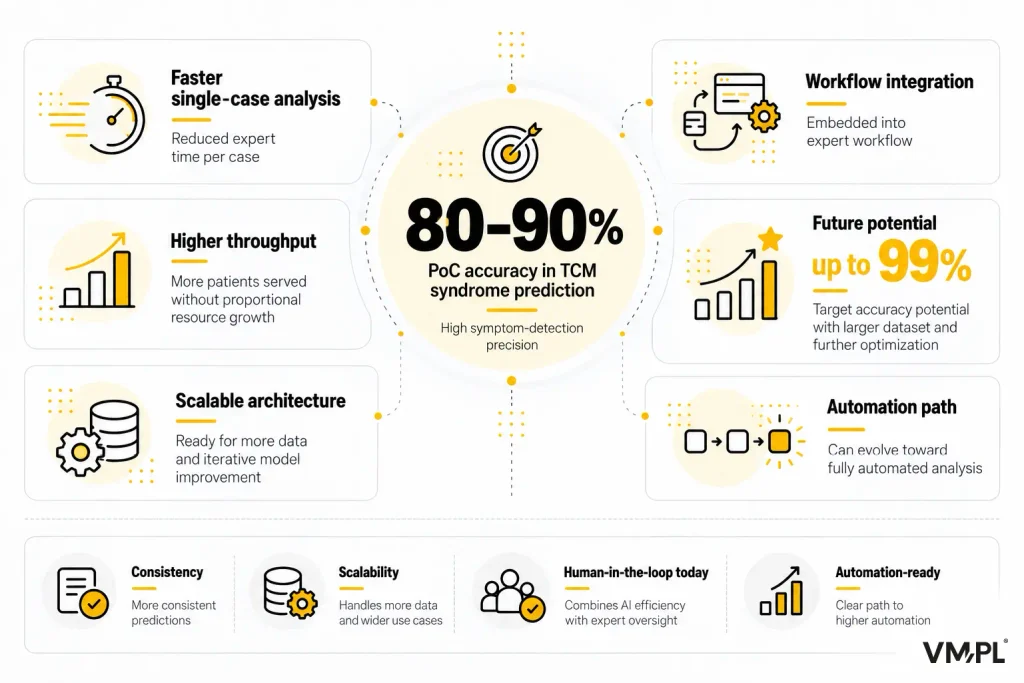
In der Proof-of-Concept-Phase erreichte das System eine Genauigkeit von 80 bis 90 Prozent bei der Vorhersage von TCM-Syndromen und gleichzeitig eine hohe Präzision bei der Erkennung einzelner Symptome.
Wichtig ist, dass das Modell trotz eines begrenzten und nicht idealen Datensatzes stabil bleibt, was die gewählte Architektur bestätigt.
Aus operativer Sicht wurde die Lösung erfolgreich in den Workflow integriert und hat die Analysezeit pro Fall reduziert. Dadurch können Sie mehr Patienten betreuen, ohne die Ressourcen proportional zu erhöhen.
Die Systemarchitektur ist auf die weitere Entwicklung ausgelegt, sowohl hinsichtlich der Skalierung der Daten als auch der iterativen Verbesserung der Modelle. Mit wachsendem Datensatz und weiterer Optimierung wurde ein Potenzial identifiziert, eine Genauigkeit von nahezu 99 Prozent zu erreichen.
Langfristig kann das System in einen vollständig automatisierten Modus übergehen, in dem die Rolle des Experten reduziert oder ganz entfällt und die Ergebnisse direkt an den Patienten übermittelt werden.
Design, Development, DevOps czy Cloud – jakiego zespołu potrzebujesz, aby przyspieszyć pracę nad swoimi projektami? Porozmawiaj o swoich potrzebach z naszymi specjalistami.
Jakub Orczyk
Członek zarządu / Dyrektor sprzedaży
Zamów bezpłatną konsultację