





 AI/ML
 Rozwój oprogramowania


Jak zbudowaliśmy system AI do analizy języka w oparciu o TCM
Klient
Klient rozwija cyfrowe usługi diagnostyczne w obszarze Tradycyjnej Medycyny Chińskiej (TCM), gdzie analiza języka jest jednym z kluczowych elementów oceny stanu zdrowia pacjenta. W praktyce oznacza to pracę na obrazach oraz interpretację subtelnych cech wizualnych – takich jak kolor, nalot, pęknięcia czy odciski zębów – które następnie mapowane są na zestaw syndromów diagnostycznych.
Dotychczas cały proces był wykonywany manualnie przez eksperta. Ograniczało to skalę działania (liczba analiz była bezpośrednio zależna od dostępności specjalisty), wydłużało czas oczekiwania na wynik i wprowadzało naturalną zmienność interpretacyjną. Klient potrzebował rozwiązania, które zwiększy przepustowość procesu bez utraty jakości, a docelowo pozwoli na jego częściową lub pełną automatyzację.
Wyzwanie
Największym wyzwaniem nie było samo zastosowanie deep learningu, tylko stworzenie sensownego pipeline’u AI w warunkach dalekich od „laboratoryjnych”.
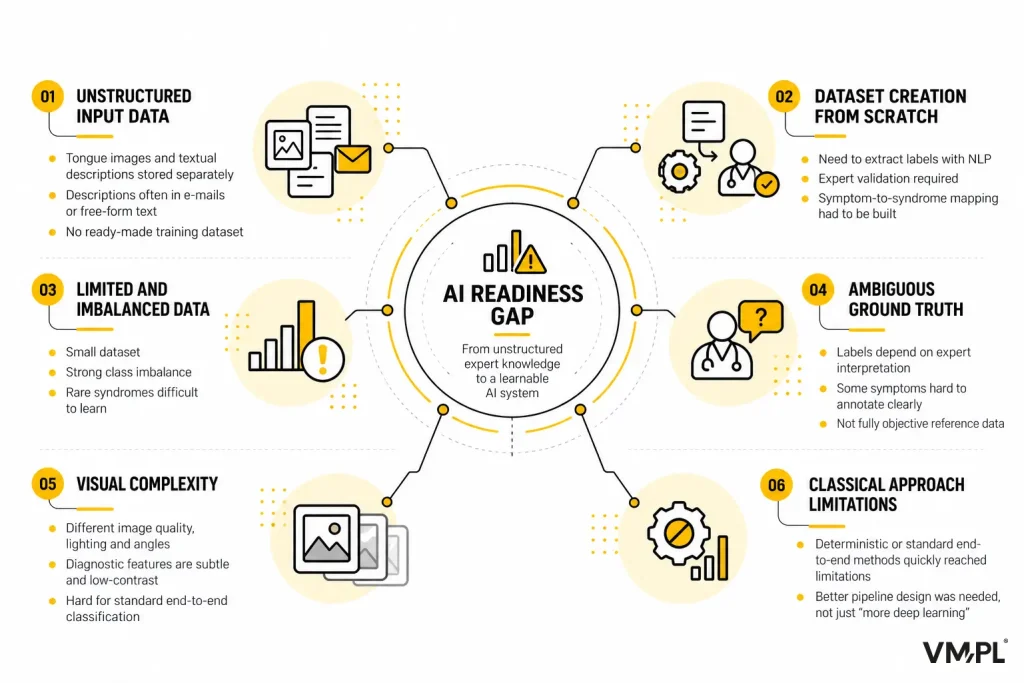
Dane wejściowe były nieustrukturyzowane – zdjęcia języka i ich opisy funkcjonowały oddzielnie, często w wątkach mailowych, a same opisy miały formę swobodnego tekstu. To oznaczało brak gotowego zbioru treningowego i konieczność jego zbudowania od podstaw, łącznie z ekstrakcją etykiet przy użyciu NLP oraz ich walidacją ekspercką.
Dodatkowo liczba danych była ograniczona, a rozkład klas silnie niezbalansowany. Część syndromów występowała rzadko, co utrudniało trenowanie modeli w klasycznym ujęciu klasyfikacyjnym. Problem pogłębiał fakt, że ground truth nie był w pełni obiektywny – interpretacja zależała od eksperta, a niektóre symptomy były trudne do jednoznacznego oznaczenia.
Od strony wizualnej również nie było „łatwo”: zdjęcia różniły się jakością, oświetleniem i kątem wykonania, a same cechy diagnostyczne często miały charakter subtelnych, nisko kontrastowych zmian. W praktyce oznaczało to, że standardowe podejście typu end-to-end classification szybko osiągało swoje ograniczenia.
Rozwiązanie
Zamiast jednego modelu klasyfikacyjnego zaprojektowaliśmy pipeline zgodny z logiką eksperta.
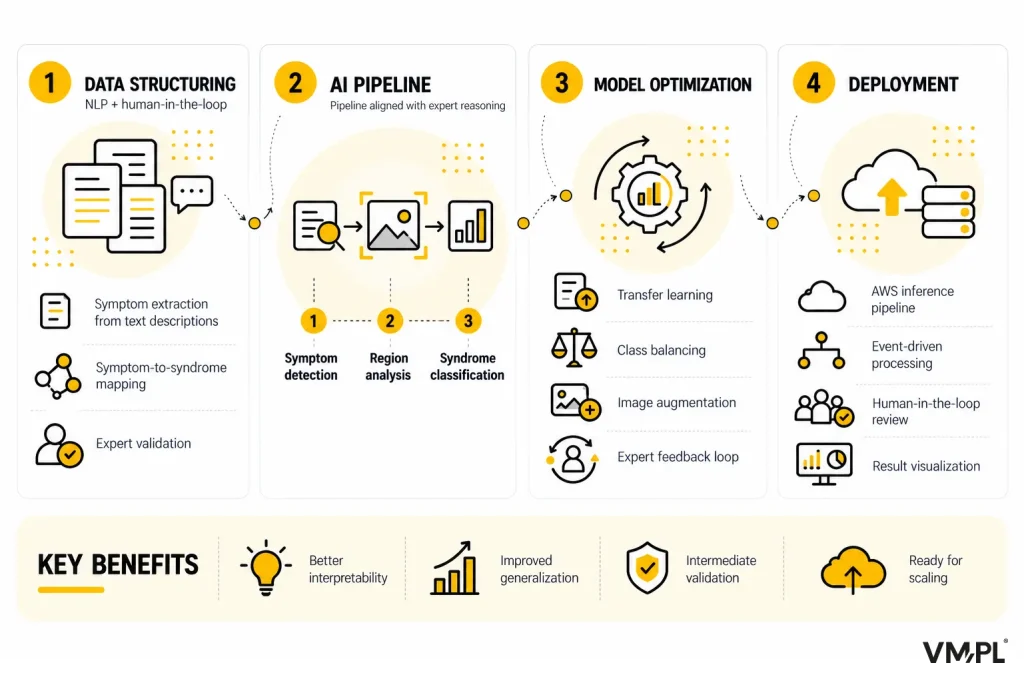
1. Strukturyzacja danych (NLP + human-in-the-loop)
- ekstrakcja symptomów z opisów tekstowych
- budowa słownika cech i mapowania symptom → syndrom
- walidacja przez eksperta (iteracyjnie)
2. Architektura modelu (CNN + transfer learning)
Porównaliśmy dwa podejścia:
A. End-to-end klasyfikacja syndromów
→ szybka, ale niska interpretowalność i gorsze wyniki
B. Pipeline trzystopniowy (końcowy):
- detekcja symptomów (multi-label)
- analiza regionów języka (lokalizacja cech)
- klasyfikacja syndromów
Dlaczego to działało lepiej:
- rozbicie problemu na łatwiejsze podzadania
- lepsza generalizacja przy małym zbiorze danych
- możliwość walidacji pośrednich wyników
3. Optymalizacja
- transfer learning (pretrained CNN)
- balansowanie klas
- augmentacja danych obrazowych
- iteracyjna walidacja z ekspertem (feedback loop)
4. Wdrożenie (production-ready PoC)
- AWS (skalowalny inference pipeline)
- event-driven processing (po uploadzie zdjęć)
- wizualizacja wyników (highlight symptomów na obrazie)
- tryb human-in-the-loop (ekspert jako walidator)
Rezultaty
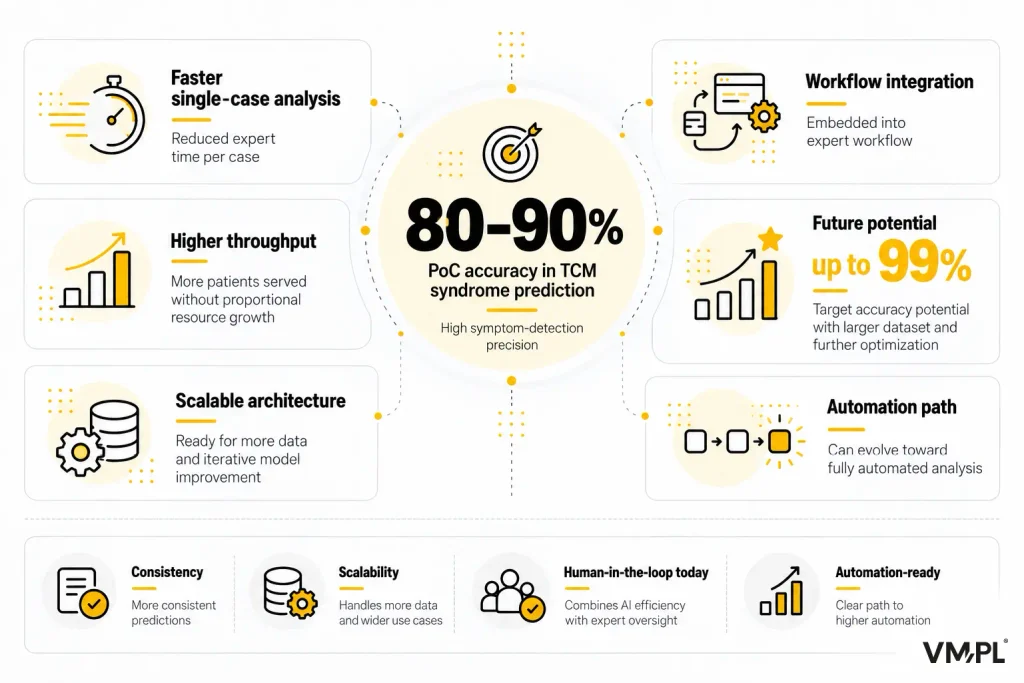
Na etapie Proof of Concept system osiągnął skuteczność na poziomie 80–90% w predykcji syndromów TCM, przy jednocześnie wysokiej trafności detekcji poszczególnych symptomów. Co istotne, model zachowuje stabilność mimo ograniczonego i nieidealnego datasetu, co potwierdza zasadność przyjętej architektury.
Z perspektywy operacyjnej rozwiązanie zostało realnie wpięte w workflow eksperta i skróciło czas analizy pojedynczego przypadku, pozwalając obsłużyć większą liczbę pacjentów bez proporcjonalnego zwiększania zasobów.
Architektura systemu jest przygotowana na dalszy rozwój – zarówno pod kątem skalowania danych, jak i iteracyjnego poprawiania modeli. Wraz ze wzrostem datasetu i dalszą optymalizacją zidentyfikowano potencjał osiągnięcia dokładności zbliżonej do 99%.
Docelowo system może przejść w tryb w pełni automatyczny, gdzie rola eksperta zostanie ograniczona lub całkowicie wyeliminowana, a wynik analizy będzie trafiał bezpośrednio do pacjenta.
Design, Development, DevOps czy Cloud – jakiego zespołu potrzebujesz, aby przyspieszyć pracę nad swoimi projektami? Porozmawiaj o swoich potrzebach z naszymi specjalistami.
Jakub Orczyk
Członek zarządu / Dyrektor sprzedaży
Zamów bezpłatną konsultację